Newsletter
Suscríbete a nuestro Newsletter y entérate de las últimas novedades.
https://centrocompetencia.com/wp-content/themes/Ceco
volver
La econometría es la aplicación de métodos estadísticos al estudio de fenómenos económicos, con el objetivo de usar datos para cuantificar relaciones entre variables, contrastar hipótesis y responder preguntas económicas concretas (Wooldridge, 2010). A modo de ejemplo, si se observa que el precio de un mismo bien es más alto en las regiones extremas en comparación con la zona central, la econometría permite medir esa brecha y analizar si ciertos factores, como un mayor costo de transporte, la explican.
El análisis de datos cumple distintos roles. Puede usarse para describir lo que ocurre en un mercado, para predecir el comportamiento futuro de una variable o para determinar si existe una relación causal entre dos fenómenos. Las exigencias no son las mismas: para predecir basta con que dos variables se muevan juntas de forma estable, mientras que para afirmar que una causa la otra hay que descartar las demás explicaciones posibles.
Para realizar un análisis econométrico es necesario conocer la estructura que tienen los datos disponibles, la que depende de las unidades observadas y del período en que se las observa.
Las tablas de esta sección usan un mismo ejemplo, el precio de la bencina, para ilustrar la diferencia entre las distintas estructuras de datos, de modo que lo único que cambie entre ellas sea la forma en que se ordenan las observaciones.
Las bases de datos de corte transversal contienen información sobre distintas unidades, como personas, empresas, comunas o países, observadas en un mismo período (Wooldridge, 2010).
En la Tabla 1 cada fila es una empresa y todas se observan en 2025, por lo que esta estructura permite comparar los precios promedio y las ventas entre empresas.
Tabla 1: Ejemplo de datos de corte transversal
| Empresa | Año | Precio promedio ($/litro) | Ventas (millones de litros) |
|---|---|---|---|
| A | 2025 | 1.284 | 1.850 |
| B | 2025 | 1.276 | 1.120 |
| C | 2025 | 1.291 | 640 |
| D | 2025 | 1.302 | 210 |
Fuente: Elaboración propia con datos ilustrativos.
Una base de datos de series de tiempo contiene observaciones de una o varias variables a lo largo de distintos períodos (Wooldridge, 2010), lo que permite analizar su evolución, es decir, en cómo cambia la variable a través del tiempo. Por esta razón, el orden de las observaciones es relevante.
Este tipo de bases de datos permite estudiar tendencias y patrones estacionales, así como realizar predicciones.
La Tabla 2 muestra cómo cambian el precio promedio y las ventas de la bencina en Chile entre enero y abril de 2025.
Tabla 2: Ejemplo de serie de tiempo
| Mes | Precio promedio nacional ($/litro) | Ventas nacionales (millones de litros) |
|---|---|---|
| Enero 2025 | 1.268 | 342 |
| Febrero 2025 | 1.275 | 318 |
| Marzo 2025 | 1.291 | 331 |
| Abril 2025 | 1.284 | 309 |
Fuente: Elaboración propia con datos ilustrativos.
Las bases de datos de panel (o datos longitudinales) siguen a las mismas unidades durante varios períodos, por lo que combinan una dimensión de corte transversal con una temporal (Wooldridge, 2010). Esta estructura permite estudiar tanto las diferencias entre unidades como los cambios dentro de una misma unidad, y es la estructura de datos base que permite utilizar métodos econométricos como efectos fijos y diferencias en diferencias.
La Tabla 3 muestra la trayectoria de las empresas A y B entre 2023 y 2025.
Tabla 3: Ejemplo de datos de panel
| Empresa | Año | Precio promedio ($/litro) | Ventas (millones de litros) |
|---|---|---|---|
| A | 2023 | 1.198 | 1.790 |
| A | 2024 | 1.247 | 1.822 |
| A | 2025 | 1.284 | 1.850 |
| B | 2023 | 1.185 | 1.080 |
| B | 2024 | 1.239 | 1.101 |
| B | 2025 | 1.276 | 1.120 |
Fuente: Elaboración propia con datos ilustrativos.
La inferencia causal busca determinar qué ocurriría con una variable (Y) si solo se modificara otra (X) que la afecta directamente. El objetivo va más allá de constatar que dos variables están relacionadas, ya que una misma asociación entre X e Y puede deberse a que X afecta a Y, a que Y afecta a X o a que una tercera variable Z afecta a ambas (Grau, 2021). Con datos de X e Y, las tres situaciones pueden resultar indistinguibles, pero solo en la primera una intervención sobre X modifica Y.
Un efecto causal es el cambio que se produce en una variable como consecuencia de modificar otra. Para conocer el efecto de una fusión sobre los precios, no basta con constatar que los precios aumentaron después de la operación. Es necesario determinar cuánto de ese cambio se debe a la fusión y no a otros factores, como el costo de los insumos o la demanda.
Para ello se utiliza el concepto de ceteris paribus, expresión latina que significa manteniendo todo lo demás constante. Identificar un efecto causal exige aislar la variable de interés de todo lo demás que también podría explicar el resultado. Esta noción es central en el análisis econométrico (Wooldridge, 2010). Dado que en la práctica, en economía, rara vez es posible mantener literalmente todo constante, existen distintos métodos de estimación que buscan aproximarse a esa condición.
La correlación existe cuando dos variables tienden a moverse juntas, ya sea en la misma dirección o en direcciones opuestas. La causalidad requiere, además, que un cambio en una variable sea lo que produzca un cambio en la otra.
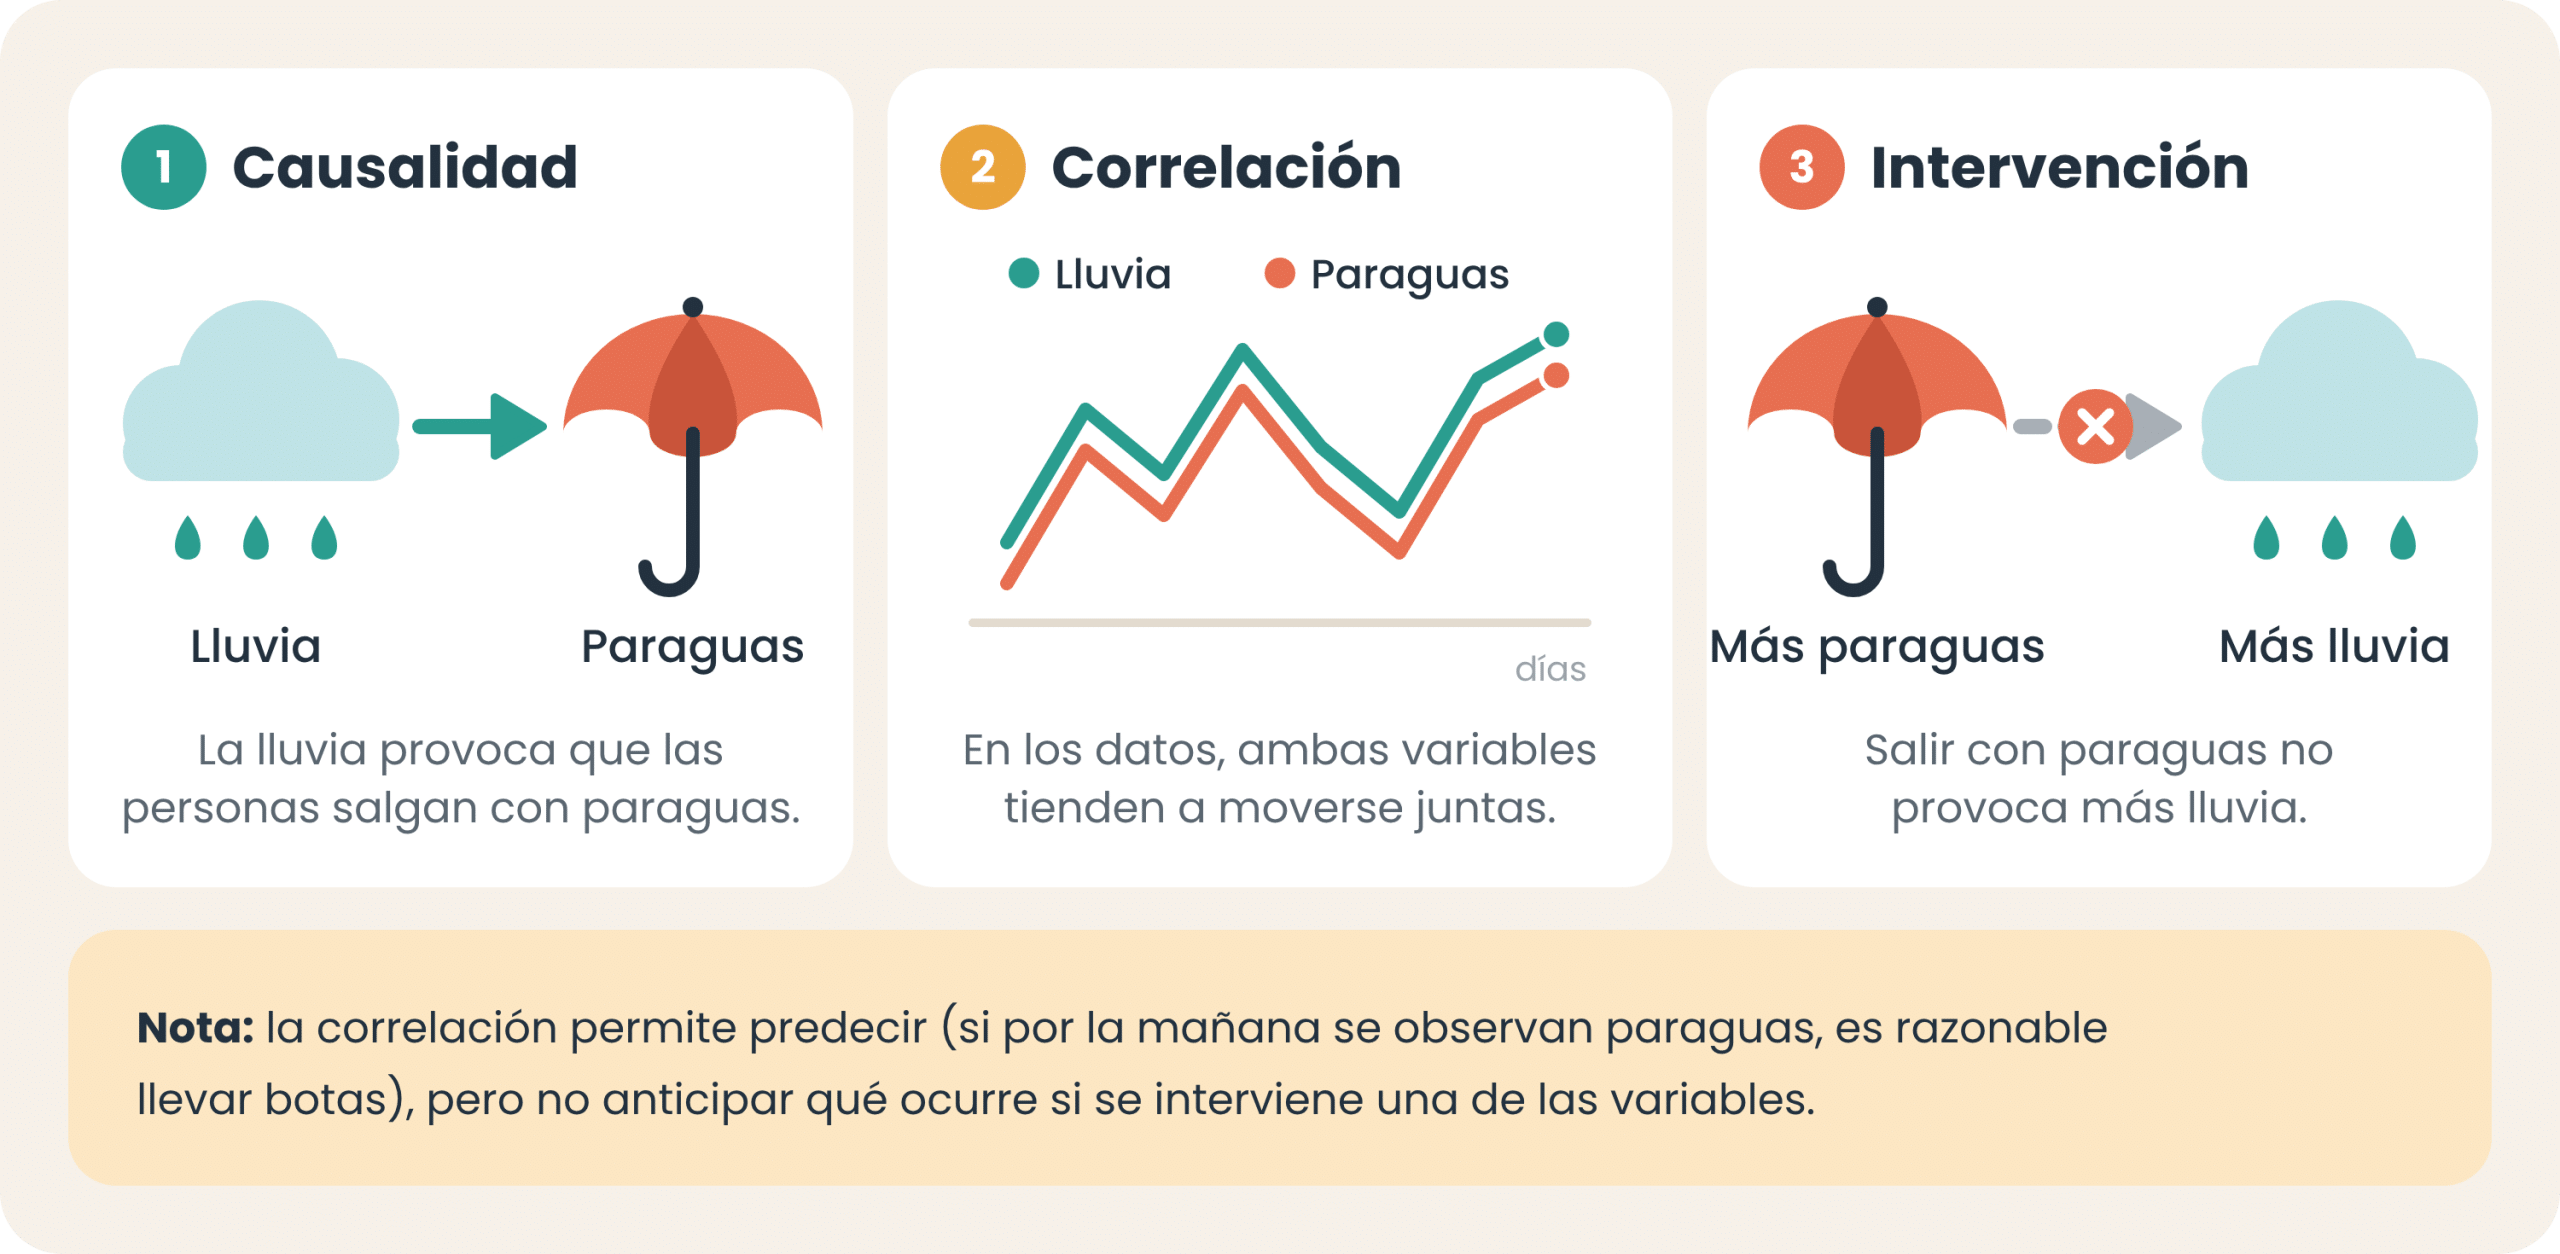
Grau (2021) ilustra esta diferencia con el caso de la lluvia y los paraguas (Figura 1). Cuando llueve, más personas salen con paraguas, por lo que ambas variables están correlacionadas positivamente. Sin embargo, que más personas salgan a la calle con paraguas no provocaría lluvia, porque la causalidad va de la lluvia a los paraguas y no al revés. Aun así, la correlación tiene utilidad: si por la mañana se observa gente con paraguas, es razonable salir con botas. Permite predecir, pero no anticipar qué ocurrirá al intervenir sobre una variable, que es lo relevante al evaluar una política o una conducta.
Figura 1: Correlación y causalidad en el ejemplo de la lluvia y los paraguas
Fuente: Elaboración propia en base a Grau (2021).
En materia de libre competencia, esta distinción es frecuente. Que los mercados más concentrados tengan precios más altos no demuestra que la concentración sea la causa de esos precios, porque en mercados pequeños o alejados puede haber espacio para pocas empresas y, al mismo tiempo, costos más altos.
Un contrafactual consiste en determinar lo que habría ocurrido en un escenario distinto del observado (factual). En particular, considera un escenario en el cual la variable de interés es distinta a la observada, pero todo el resto permanece constante (Contreras, 2023). Por ejemplo, para conocer el efecto de una fusión sobre los precios sería necesario saber cuál habría sido la evolución de esos mismos precios, en el mismo período, si lo único distinto que hubiera ocurrido es que no se realizó la fusión.
El problema es que ambos escenarios no pueden observarse al mismo tiempo. Para cada unidad i existen dos resultados potenciales, Y_{1i} si la unidad de observación i recibe el tratamiento e Y_{0i} si no lo recibe, y el efecto causal es Y_{1i} - Y_{0i}. Sin embargo, en los datos solo aparece uno de los dos.
Por ello, el análisis causal busca una comparación que permita aproximar el resultado no observado. El grupo tratado reúne a las unidades expuestas al evento o política que se estudia, y el grupo de control, a unidades no expuestas que sirven de referencia para estimar qué habría ocurrido con las unidades tratadas en ausencia del tratamiento. En el caso de los ginecólogos de Ñuble, el Tribunal de Defensa de la Libre Competencia (TDLC) utilizó la evolución de los precios del resto de la Región del Biobío como contrafactual de lo que habría ocurrido en Ñuble sin el acuerdo entre médicos (TDLC, 2015).
El sesgo de selección aparece cuando una muestra de observaciones no es aleatoria. Por ejemplo, al comparar el grupo tratado con el de control, es posible que difieran en características que no tienen relación con tratamiento y que también afectan el resultado, de modo que la comparación combina el efecto del tratamiento con esas diferencias previas. Un caso en libre competencia es la evaluación de los programas de cumplimiento. Si estos se asignaran al azar entre empresas, comparar las infracciones de las empresas con y sin programa permitiría estimar su efecto; si cada empresa decide si adoptarlos, ambos grupos pueden ser distintos desde antes (Contreras, 2023).
Si D_{i} vale 1 para los tratados \left( D_{i} = 1 \right) y el tratamiento tiene un efecto \alpha, la comparación simple de promedios se descompone en:
\displaystyle E\left[ Y_{i} \mid D_{i} = 1 \right] - E\left[ Y_{i} \mid D_{i} = 0 \right] = \alpha + \left( E\left[ Y_{0i} \mid D_{i} = 1 \right] - E\left[ Y_{0i} \mid D_{i} = 0 \right] \right)
donde el término entre paréntesis es el sesgo de selección, es decir, la diferencia que habría entre ambos grupos aun sin tratamiento.
Su forma más común es la autoselección, que ocurre cuando las propias personas o empresas deciden someterse al tratamiento. En el ejemplo, es más probable que las empresas que adoptan programas de cumplimiento hayan sido más cuidadosas desde antes, por lo que una comparación que no considere el sesgo de selección, es decir, que no contemple esa razón, atribuiría todo el efecto al programa.
Un estimador es la regla o fórmula que indica cómo usar las observaciones de una muestra de datos para aproximar un parámetro poblacional, y la estimación es el número que resulta al aplicarla a una muestra concreta. En términos simples, el parámetro poblacional es un valor fijo, aunque desconocido, de la población, como el precio promedio de la bencina en todas las estaciones del país. Dado que rara vez es posible observar a toda la población, en este caso, a todas las estaciones del país, ese valor se aproxima con los datos de una muestra de estaciones.
Un primer ejemplo de estimador es el promedio muestral, que aproxima el precio promedio poblacional mediante el promedio de los precios observados en la muestra: \overline{Y} = \frac{1}{n}\sum_{i = 1}^{n}Y_{i}.
Un segundo ejemplo es el estimador de mínimos cuadrados ordinarios (MCO) de la pendiente de una regresión, que corresponde a la covarianza muestral entre X e Y dividida por la varianza muestral de X (Grau, 2021):
\displaystyle \hat{\beta}_{1} = \frac{\sum_{i = 1}^{n}\left( X_{i} - \overline{X} \right)\left( Y_{i} - \overline{Y} \right)}{\sum_{i = 1}^{n}\left( X_{i} - \overline{X} \right)^{2}}
Un mismo estimador, aplicado a muestras distintas, puede producir estimaciones distintas. Por ejemplo, el promedio calculado con los precios de las estaciones A, B y C no necesariamente coincide con el precio promedio calculado con las estaciones D, E y F, aunque ambos usen la misma fórmula. Por esa razón, un estimador se evalúa por su comportamiento en el conjunto de muestras posibles.
Las propiedades que se presentan a continuación permiten evaluar si sus estimaciones se acercan al parámetro poblacional, en promedio o a medida que crece la muestra.
4.2.i. Insesgado
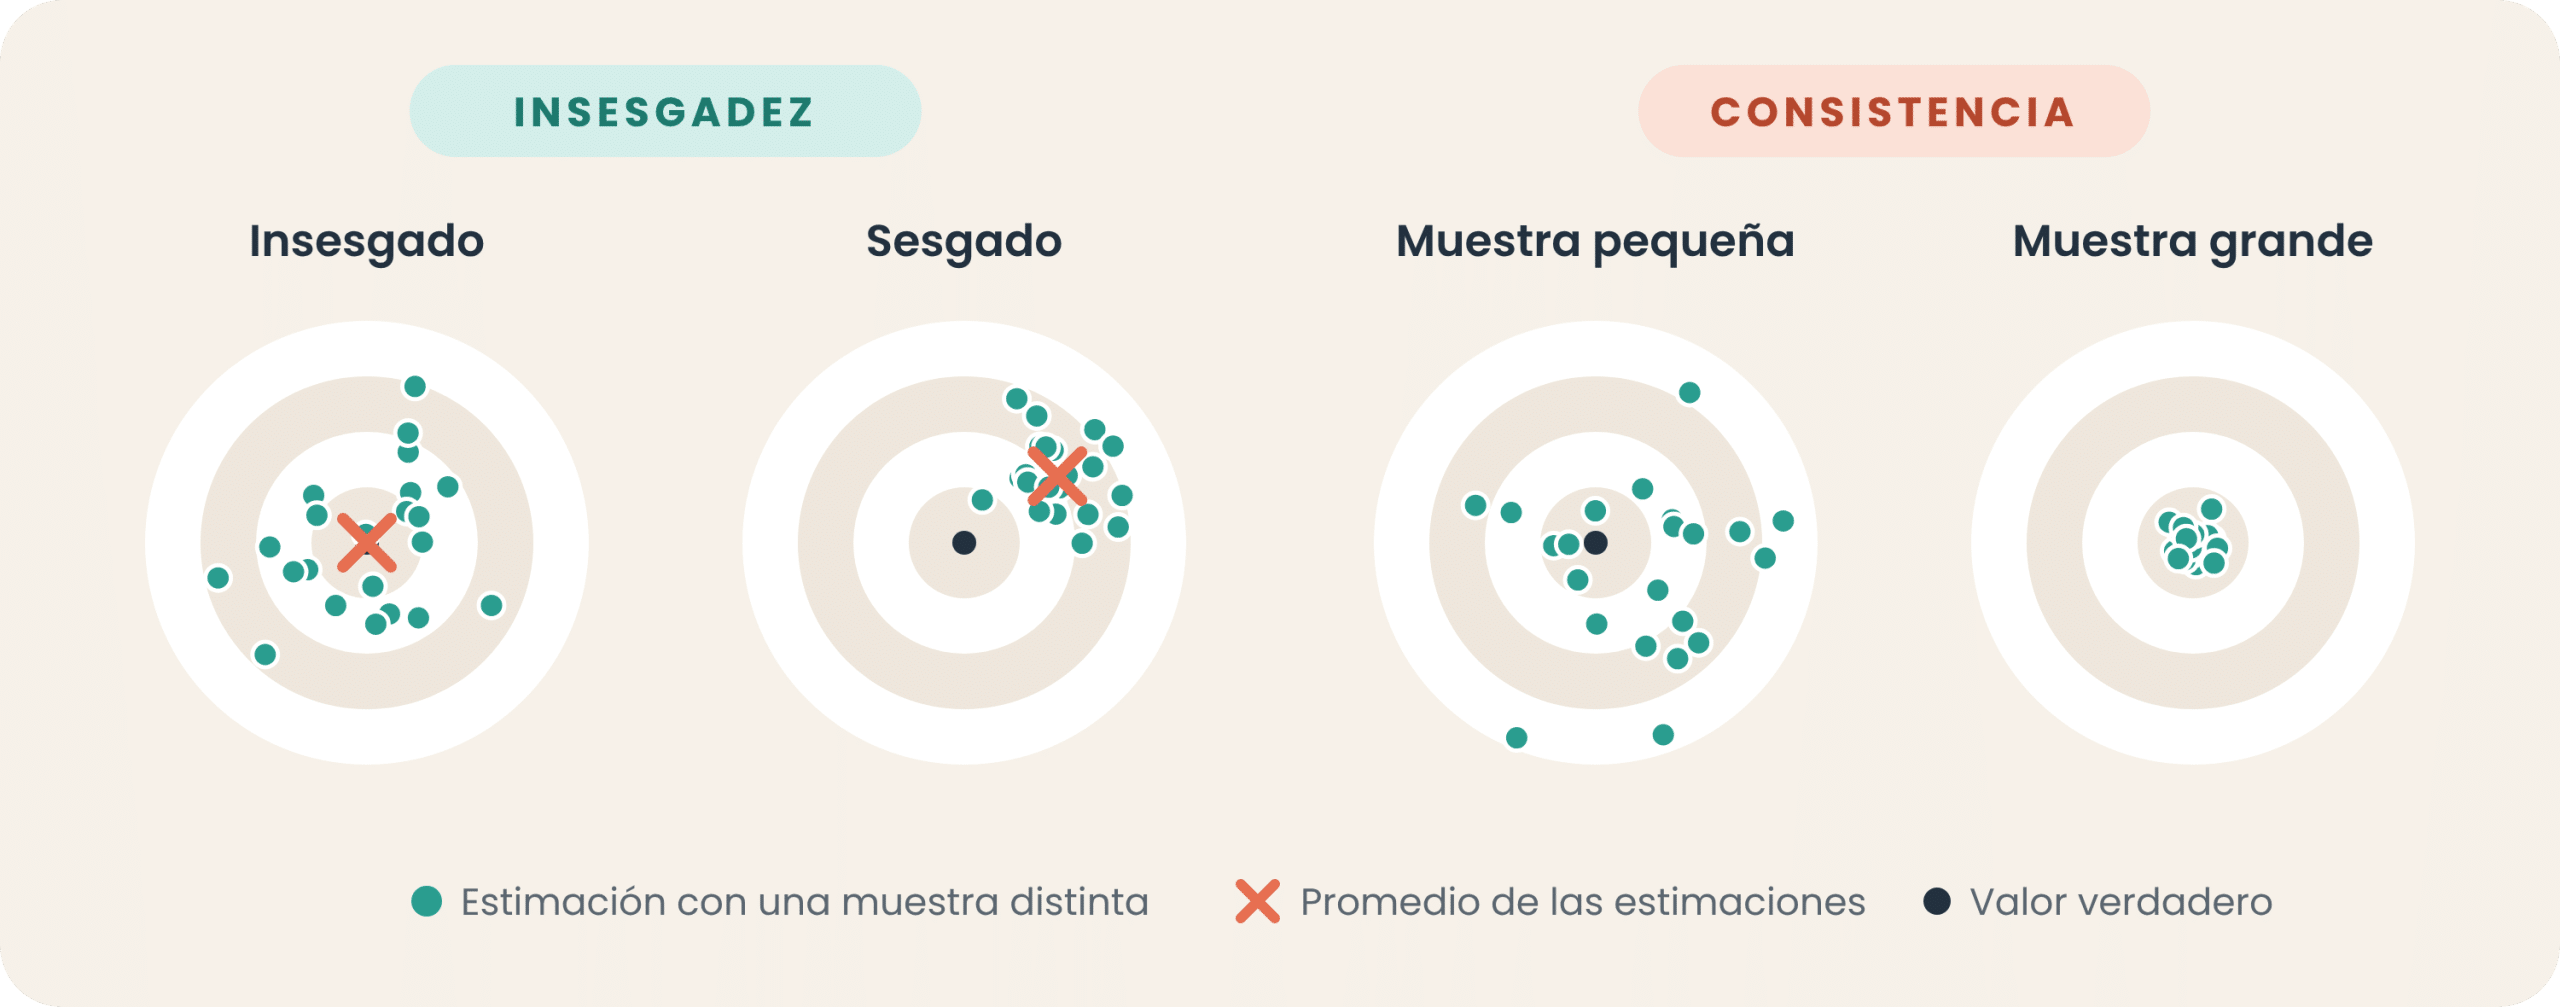
Un estimador [\hat{\theta}] de un parámetro [\theta] es insesgado si E\left[ \hat{\theta} \right] = \theta, es decir, si al repetir la estimación con muchas muestras distintas el promedio de esas estimaciones coincide con el valor verdadero del parámetro.
Cada estimación individual puede quedar por encima o por debajo de ese valor, pero no existe una tendencia sistemática a hacerlo en un mismo sentido. La diferencia E\left[ \hat{\theta} \right] - \theta se denomina sesgo, de modo que un estimador es insesgado cuando su sesgo es cero.
4.2.ii. Consistente
Un estimador \hat{\theta} de un parámetro \theta es consistente si, a medida que crece el tamaño de la muestra, sus estimaciones se concentran cada vez más en torno al valor verdadero del parámetro, lo que se expresa como \text{plim}\,\hat{\theta}_{n} = \theta. En esta notación, plim es el límite en probabilidad, es decir, a medida que la muestra crece, la probabilidad de que la estimación se aleje del valor verdadero se acerca a cero.
Figura 2: Insesgadez y consistencia de un estimador
Fuente: Elaboración propia.
Insesgadez y consistencia son propiedades distintas (Figura 2). Por ejemplo, si se usa solo el precio de la primera estación de la muestra para estimar el promedio, el estimador es insesgado, porque en promedio acierta, pero no es consistente. Aunque la muestra tenga miles de estaciones, la estimación sigue dependiendo del precio de una sola de ellas, de modo que su dispersión no disminuye y la probabilidad de equivocarse por un margen relevante no se acerca a cero (Wooldridge, 2010).
En el caso de MCO, la insesgadez y la consistencia requieren, entre otros supuestos, que los factores no observados que afectan el resultado no estén correlacionados con la variable de interés. Si ese supuesto no se cumple, como ocurre con el sesgo de selección o con una variable omitida, aumentar el tamaño de la muestra no corrige el problema, sino que solo permite obtener una estimación cada vez más precisa de un valor equivocado.
Definición y modelo. La regresión lineal simple relaciona una variable dependiente Y con una única variable explicativa X:
\displaystyle Y_{i} = \beta_{0} + \beta_{1}X_{i} + u_{i} (para todo i)
donde i es la unidad de observación (individuos, familias, colegios, empresas, regiones, países, etc.), Y_{i} es la variable dependiente, X_{i} es la variable independiente (regresor), \beta_{0} es el coeficiente poblacional denominado intercepto y \beta_{1} es el coeficiente poblacional denominado pendiente, que mide cuánto cambia Y cuando X aumenta en una unidad. Además, \beta_{0} + \beta_{1}X_{i} es la línea de regresión poblacional y u_{i} es el término de error (Rodríguez, 2025).
Por ejemplo, Y_{i} puede ser el precio de la bencina en la comuna i y X_{i} el número de estaciones de servicio. El término de error u_{i} agrupa todos los demás factores no observados que afectan a Y. Los parámetros se estiman por MCO, método que escoge la recta que minimiza la suma de los residuos al cuadrado (Grau, 2021).
Interpretación del parámetro. El coeficiente de interés \beta_{1} mide el efecto causal, es decir, cuánto cambia Y cuando X aumenta en una unidad, manteniendo constante todo lo que está en u.
Si \hat{\beta}_{1} = - 8, esto indica que, ante una estación de servicio adicional, el precio de la bencina disminuye en 8 pesos por litro, manteniendo todo lo demás constante.
Supuestos. Para que MCO sea insesgado se requiere linealidad en los parámetros, muestreo aleatorio, variación en X y, sobre todo, media condicional cero. Esto significa que E[ u \mid X] = 0, es decir, que los factores no observados no estén relacionados con X. La homocedasticidad, es decir, que la varianza del error sea constante, no afecta el sesgo, pero se necesita para que los errores estándar habituales sean válidos (Wooldridge, 2010).
Estadístico \mathbf{t} y nivel de significancia estadística. El nivel de significancia (\alpha) es la probabilidad de concluir que existe un efecto cuando realmente no lo hay. Para ello, se establece una hipótesis nula \left( H_{0} \right) –suposición inicial, por ejemplo, la ausencia de un efecto– y una hipótesis alternativa \left( H_{1} \right) –que postula lo contrario a \left( H_{0} \right)–. Por lo tanto, el nivel de significancia es la probabilidad de rechazar la hipótesis nula cuando en realidad es verdadera. Al evaluar la significancia, los niveles más utilizados son 1%, 5% y 10%, que en las tablas suelen marcarse con ***, ** y *.
En el ejemplo de la bencina, si la hipótesis nula es H_{0}:\beta_{1} = 0, se plantea que el número de estaciones de servicio no tiene un efecto sobre el precio de la bencina. La hipótesis alternativa, H_{1}:\beta_{1} \neq 0 plantea lo contrario (que sí tiene efecto).
Para determinar si \beta_{1} es significativo o no, se utiliza un estadístico de prueba, que, bajo la hipótesis nula, se aproxima a una distribución normal \sim N(0{,}1) en muestras grandes. Cuando la hipótesis nula es la ausencia de efecto \left( H_{0}:\beta_{1} = 0 \right), el estadístico se calcula como:
\displaystyle t = \frac{\hat{\beta}_{1}}{\text{SE}(\hat{\beta}_{1})}
donde \text{SE}(\hat{\beta}_{1}) corresponde al error estándar (SE, por Standard Error), que mide cuánto varía el estimador \hat{\beta}_{1} de una muestra a otra. Si la hipótesis nula fuera otro valor c \left( H_{0}:\beta_{1} = c \right), el estadístico se calcula restando c al coeficiente estimado, es decir, t = \frac{\hat{\beta}_{1} - c}{\text{SE}(\hat{\beta}_{1})} .
El estadístico t permite determinar si un coeficiente es estadísticamente distinto del valor planteado en la hipótesis nula (cero, en este ejemplo) al compararlo con un t_{\text{cr\'{\i}tico}} asociado a un nivel de significancia. Si se asume \alpha = 5\%, esto corresponde a un t_{\text{cr\'{\i}tico}} = 1{,}96 en valor absoluto:
También es posible utilizar el valor p, que se compara con el nivel de significancia (5\%):
Si un coeficiente es significativo al 5\%, esto quiere decir que, si el efecto real fuera cero, una estimación al menos tan alejada del cero ocurriría menos del 5\% de las veces.
En el ejemplo de la sección 6.1 (Laboratorios Recalcine), el estadístico t = 17{,}2 es mayor que el t_{\text{cr\'{\i}tico}} = 1{,}96 al 5\% de significancia, por lo que se rechaza la hipótesis nula. Esto significa que la variable \text{Farmacia}_{i} tiene un efecto significativo sobre el \text{precio}_{i}.
Cabe señalar que la significancia estadística no es lo mismo que magnitud del efecto. Por ello, siempre es importante considerar el signo, el tamaño y la relevancia económica del coeficiente (Contreras, 2023).
Intervalo de confianza. El intervalo de confianza es un rango de valor, calculado a partir de la muestra, que contiene al parámetro poblacional en una proporción determinada de las muestras posibles. Se construye como:
\displaystyle \text{Prob}\left( \hat{\beta}_{1} - t_{\text{cr\'{\i}tico}} \cdot \text{SE}\left( \hat{\beta}_{1} \right) < \beta_{1} < \hat{\beta}_{1} + t_{\text{cr\'{\i}tico}} \cdot \text{SE}\left( \hat{\beta}_{1} \right) \right) = 100\% - \alpha
Por ejemplo, con a = 5\%, el intervalo es:
\displaystyle \text{Prob}\left( \hat{\beta}_{1} - 1{,}96 \cdot \text{SE}\left( \hat{\beta}_{1} \right) < \beta_{1} < \hat{\beta}_{1} + 1{,}96 \cdot \text{SE}\left( \hat{\beta}_{1} \right) \right) = 95\%
Esto significa que, si se repitiera el muestreo muchas veces, aproximadamente 95 de cada 100 intervalos construidos de esa forma \left( \hat{\beta}_{1} - 1{,}96 \cdot \text{SE}\left( \hat{\beta}_{1} \right) \right) contendrían el verdadero \beta_{1}. Si el intervalo no incluye el cero, se dice que el efecto es estadísticamente distinto de cero.
Interpretación variable dummy. Cuando X es una variable dummy o binaria (D_{i}), es decir, una variable que toma valor 1 si la unidad cumple una condición (por ejemplo, formar parte de un joint venture) y 0 si no, \beta_{1} es la diferencia de promedios entre ambos grupos.
Por ejemplo, en una estimación de costos (Y), si D_{i} = 1 cuando la empresa i forma parte del joint venture y D_{i} = 0 en caso contrario, el coeficiente de interés \beta_{1} representa el efecto sobre los costos de las empresas que forman parte del joint venture. Si \beta_{1} = 200 mil pesos chilenos, las empresas que forman parte del joint venture tienen, en promedio, costos 200.000 pesos chilenos mayores que las que no, si todo lo demás se mantiene constante.
\mathbf{R}^{\mathbf{2}}. El \mathbf{R}^{\mathbf{2}} mide qué fracción de la varianza de Y es explicada por el modelo y toma valores que van entre 0 y 1 (Rodríguez, 2025).
La regresión lineal múltiple extiende la regresión lineal simple al incluir más de una variable explicativa en el modelo:
\displaystyle Y_{i} = \beta_{0} + \beta_{1}X_{1i} + \beta_{2}X_{2i} + \ldots + \beta_{k}X_{ki} + u_{i}
Sesgo por variable omitida. Si se omite una variable X_{2}, que afecta a Y y está correlacionada con X_{1}, la estimación puede sufrir sesgo de variable omitida. Esto significa que el coeficiente estimado \hat{\beta}_{1} puede estar subestimado –el efecto real es mayor que el estimado– o sobreestimado –el efecto real es menor que el estimado–, ya que \hat{\beta}_{1} absorbe parte del efecto generado por otra variable que no se incluye en el modelo.
En el modelo de regresión múltiple, cada coeficiente se interpreta ceteris paribus respecto de las demás variables incluidas. Por eso, suele presentarse como una posible solución al sesgo por variable omitida: si se agrega la distancia al terminal, el coeficiente del número de estaciones deja de capturar el costo de transporte. Sin embargo, es una solución parcial (Grau, 2021), porque solo controla por las variables observadas. Factores como la calidad de la gestión o la estrategia de cada empresa permanecen en el término de error.
Cálculo del sesgo por variable omitida. Considérese la regresión estimada en la subsección anterior: Y_{i} = \beta_{0} + \beta_{1}X_{1} + u_{i}, donde Y_{i} es el precio de la bencina y X_{1} es el número de estaciones de servicio; y, también la nueva regresión: Y_{i} = \beta_{0} + \beta_{1}X_{1} + \beta_{2}X_{2} + u_{i}, que incorpora X_{2}, la distancia de la estación de servicio al centro de abastecimiento. En presencia de sesgo por variable omitida, el coeficiente de interés en la primera regresión se puede calcular como:
\displaystyle \hat{\beta}_{1} \rightarrow \beta_{1} + \beta_{2}\,\delta_{1}
donde \beta_{2} es el efecto de X_{2} sobre Y y \delta_{1} es la relación entre X_{1} y X_{2}, calculada como \delta_{1} = \left( \frac{\text{Cov}(X_{1},X_{2})}{\text{Var}(X_{1})} \right) (Rodríguez, 2025).
Si el efecto está subestimado o sobrestimado depende de los signos de \beta_{2} y \text{Cov}(X_{1},X_{2}):
En el ejemplo del precio de la bencina y del número de estaciones de servicio, se pueden determinar los signos de \beta_{2} y \text{Cov}(X_{1},X_{2}). Por un lado, las comunas o ciudades más alejadas del terminal de combustibles (centro de abastecimiento) enfrentan mayores costos de transporte, lo que se traduce en precios más altos. Por lo tanto, \beta_{2} > 0. Por otro lado, es razonable suponer que esas mismas ciudades, al estar más alejadas de los centros de distribución, tengan menos estaciones de servicio. Por lo tanto, \text{Cov}(X_{1},X_{2}) < 0.
Dado que \beta_{2} > 0 y \text{Cov}(X_{1},X_{2}) < 0, el sesgo por variable omitida \left( \beta_{2}\,\delta_{1} \right) debería ser negativo, es decir, la estimación MCO que omite la distancia subestima el efecto causal \hat{\beta}_{1} < \beta_{1}. Esto ocurre porque \hat{\beta}_{1} absorbe parte del efecto de la lejanía (precios más altos asociados a menos estaciones de servicio). Al incluir la distancia en la regresión, \hat{\beta}_{1} debería aumentar.
\mathbf{R}^{\mathbf{2}} y \mathbf{R}^{\mathbf{2}} \textbf{ajustado}. En el contexto de regresión múltiple, el valor del \mathbf{R}^{\mathbf{2}} se mantiene o aumenta al incluir más variables explicativas en el modelo (Rodríguez, 2025), es decir, nunca disminuye, independiente de si el regresor adicional aporta o no poder explicativo.
Por eso, se utiliza también el \mathbf{R}^{\mathbf{2}} \textbf{ajustado} \left( \overline{\mathbf{R}^{\mathbf{2}}} \right), una modificación del \mathbf{R}^{\mathbf{2}}, que corrige por grados de libertad mediante la penalización del número de variables explicativas k que no explican la varianza de Y. Esto significa que, si se añade una variable que no explica la varianza de Y, el \overline{\mathbf{R}^{\mathbf{2}}} no aumenta, aunque \mathbf{R}^{\mathbf{2}} si lo haga.
\displaystyle \overline{R}^{2} = 1 - \left( 1 - R^{2} \right)\frac{n - 1}{n - k - 1}
Sin embargo, ni el \mathbf{R}^{\mathbf{2}} ni el \overline{\mathbf{R}^{\mathbf{2}}} indican si la relación entre las variables es causal, y un \mathbf{R}^{\mathbf{2}} bajo puede ser compatible con un coeficiente bien estimado.
La libre competencia no está exenta de econometría, como lo demuestra su presencia en estudios o informes de la FNE, en sentencias o resoluciones del TDLC y en los informes económicos que las partes presentan ante el TDLC en Chile. Una situación similar ocurre en otros países.
En la causa no contenciosa Rol NC N° 490-2021, Laboratorios Recalcine acompañó un informe de Aldo González que compara los precios a los que los laboratorios venden medicamentos a la Central Nacional de Abastecimiento (Cenabast) y a las farmacias (González, 2022).
Para aislar el efecto del canal de venta, el informe estima una regresión lineal múltiple con efectos fijos que, escrita en forma simplificada, equivale a:
\displaystyle \ln\left( \text{Precio}_{i} \right) = \beta_{0} + \beta_{1}\,\text{Farmacia}_{i} + \beta_{2}\ln\left( \text{Cantidad}_{i} \right) + \text{EF} + \varepsilon_{i}
donde la variable dependiente \ln\left( \text{Precio}_{i} \right) corresponde al logaritmo del precio normalizado; \text{Farmacia}_{i} es la variable de interés, una variable dummy que toma valor 1 si la compra la realiza una farmacia y 0 si la realiza Cenabast; \ln\left( \text{Cantidad}_{i} \right) es una variable explicativa que corresponde a la cantidad adquirida; y, \text{EF} agrupa efectos fijos por principio activo, año, laboratorio y marca. Al incluir esos controles, \beta_{1} compara el precio de medicamentos del mismo principio activo, laboratorio y marca, en un mismo año, ceteris paribus.
El coeficiente de interés es \beta_{1} = 0{,}549 y es significativo al nivel de 1\% de significancia. Al ser \text{Farmacia}_{i} una variable dummy, el coeficiente indica que un mismo medicamento es cerca de 73\% más caro en farmacias (e^{0{,}549} - 1). Leer el coeficiente directamente como porcentaje (55\%) subestima el efecto, ya que esa lectura solo es precisa cuando el coeficiente es pequeño.
El coeficiente \beta_{2} = - 0{,}0785 significa que, ante un aumento de 1\% más en las unidades compradas, el precio disminuye 0{,}08\%.
El R^{2} = 0{,}90 indica que el modelo explica el 90% de la variación de los precios en una muestra de 52.979 observaciones (González, 2022, pp. 15-16).
Contreras, D. (2023). Microeconomía III. Facultad de Economía y Negocios, Universidad de Chile.
González, A. (2022). Diferenciación de precios de medicamentos por canales de venta e impactos de forzar la uniformidad.
Grau, N. (2021). Métodos Cuantitativos I. Facultad de Economía y Negocios, Universidad de Chile.
Rodríguez, J. (2025). Econometría. Facultad de Ciencias Económicas y Empresariales, Universidad de los Andes.
Tribunal de Defensa de la Libre Competencia. (2015). Sentencia N° 145/2015. Requerimiento de la Fiscalía Nacional Económica contra Asociación Gremial de Ginecólogos Obstetras de la Provincia de Ñuble y otros.
Wooldridge, J. M. (2010). Introducción a la econometría: Un enfoque moderno (4.ª ed.). Cengage Learning.